2026年9月: free-threaded Python 3.14でasyncioイベントループを複数動かす ― 速くなる処理、速くならない処理
福田(@JunyaFff)です。2026年9月の「Python Monthly Topics」では、free-threaded Pythonで複数のasyncioイベントループを動かし、I/O処理の途中にあるPythonコードを複数のCPUコアで並列実行する方法を紹介します。
はじめに
Pythonの特徴の1つであるGIL(Global Interpreter Lock) [1] は、インタープリター内部の状態を保護する一方、複数のスレッドによるPythonコードの並列実行を制限してきました。近年は、GILを無効にして複数のスレッドでPythonコードを並列実行できる「free-threaded Python」の導入が進んでいます。
このfree-threaded PythonはPython 3.13で実験的に導入され、Python 3.14ではPEP 779 -- Criteria for supported status for free-threaded Pythonにより、公式にサポートされる段階になりました。
2026年のPyCon USとEuroPythonでも、free threadingやasyncioに関するトークがいくつかありました。 関心は「GILを解放できる」ことから、「GILがないPython環境でアプリケーションをどう設計するか」へ移りつつあると感じています。
トーク |
該当のセッション |
主な内容 |
|---|---|---|
Free-threaded Python: past, present and future |
Pythonコア開発者のThomas Wouters氏によるトーク。スレッド安全性やデータ競合といった並行処理の設計が中心。2020年代中にはree-threaded Pythonがデフォルトになるという話も |
|
Demystifying the GIL |
GILの役割と、GILによって表面化しにくかった共有メモリの競合 |
|
Conquer multithreaded Python with Blanket |
スレッドの実行順序を制御し、競合を再現するテストツールBlanket |
|
Making Python Faster with Free Threading and Mypyc(EuroPythonではSpeeding Up Python with Free Threading and Mypyc) |
free threadingとmypycによる高速化と、メモリ割り当てや参照カウントの競合による制約 |
|
Lock-Free Multi-Core Performance with Behavior-Oriented Concurrency |
共有データの所有権を管理する並行処理モデル |
|
Rethinking AsyncIO from scratch for free-threaded Python |
free-threaded Python向けにasyncioを再設計するパッケージ TonIO |
|
Immutability: Fast and Safe sharing of Data across Subinterpreters |
イミュータブルなデータをサブインタープリター間で共有し、コピーを減らす試み |
|
Python Dicts: Past, Present, and Free-Threaded Future |
free threadingへの対応に伴う辞書の内部実装の変化 |
また「asyncio x free-threaded Python」に関するドキュメントもいくつか公開されています。
Python公式ドキュメントにはasyncio and free-threaded Pythonという公式ガイドが追加され、1スレッドにつき1つのイベントループを動かして複数コアを利用する構成が説明されています。
コミュニティのPython free-threading guideにも、「asyncio x free-threaded Python」の構成でWebスクレイピングを速くする例があります。
本稿では、free-threaded Pythonでスレッドごとにasyncioのイベントループを動かし、Pythonコードを複数のCPUコアで並列実行する方法を試してみます。
複数のイベントループで並列実行
asyncioなどのPython非同期で作られたアプリケーションを運用していると、ホスト全体のCPUには余裕があるのに、応答が遅くなることがあります。asyncioは、外部APIやデータベースの応答を待つ間に別のリクエストを処理できますが、その前後にある入力値の検証やデータの変換にはCPU時間が必要です。個々には短い処理でも、リクエストが増えると、イベントループを動かす1コアを使い切ることがあります。
たとえば、1リクエストあたりのCPU時間が合計1ミリ秒なら、毎秒1,000件で1コア分に達する計算です。こうした状況は、大規模なサービスでも、限られたリソースで処理をまかなう環境でも起こりえます。ほかのCPUコアに余裕があれば、それも使いたいところです。
複数コアを使う方法としては、プロセスを増やしてリクエストを分配するのが一般的です。通常版Pythonでも利用できますが、プロセスごとにメモリを使い、状態の共有にはプロセス間通信などが必要になります。
そこで、今回はfree-threaded Pythonで複数のスレッドを使い、それぞれのイベントループにリクエストを分配する方法を試してみます。1つのイベントループは1つのスレッドで動くため、GILを無効にするだけでは複数コアを活用できません。イベントループも分けることで、各スレッドのPython処理を並列に進められます。
個人的に気になったのは、I/Oと短いPython処理を繰り返すコードでの使い勝手です。計算部分をExecutorへ切り出す方法もありますが、処理が各所に散らばっていると、どこで分けるか悩みます。リクエスト単位でループを分ければ、一連の処理を1つのコルーチンとして書いたまま並列化できます。
本記事で確認すること
実際にローカルHTTPサーバーで試すと、筆者の環境では、整数演算を含む処理がfree-threaded版の4ループで1ループの3.25倍の処理件数になりました。一方、接続が1つのループに偏り、4ループにしても1.02倍にとどまった構成もありました。
本記事では、通常版とfree-threaded版を比較し、I/O待ちとCPU処理の割合によって効果がどう変わるかを確認します。ループ間でのデータ共有やExecutorとの使い分けも紹介します。確認する疑問は次のとおりです。
通常版Pythonでイベントループを増やすと速くなるのか
free-threaded Pythonでは、どのような処理が速くなるのか
HTTPサーバーのようなI/O中心の処理でも効果があるのか
4つのイベントループを作ったのに1.02倍にしかならなかったのはなぜか
イベントループを増やす際に、何を共有してよいのか
1ループ、複数ループ、Executorをどのように使い分けるのか
なお、マルチプロセス構成との直接比較は行っていません。
この記事の対象読者
本記事は、asyncio.run()、await、Taskなどasyncioの基本的な使い方を知っており、Web API、クローラー、非同期ワーカーなどでasyncioを利用しているPython開発者を主な対象とします。とくに、次のような状況が気になっている方を想定しています。
1つのイベントループが1コアを使い切り、Taskの待ち時間や遅い側のレイテンシが増えている
I/O待ちの間ではなく、
awaitとawaitの間にある短いPython処理が積み重なっているマルチプロセスやExecutorに加えて、free-threaded Pythonで利用できる選択肢を知りたい
free threadingの内部実装やC APIの知識は必要ありません。一方、asyncioを初めて使う方に向けた入門ではないため、コルーチンやイベントループの基本については、Python公式ドキュメントのasyncioの概念的な概要も併せてご覧ください。
free threadingとGILの基本については、本連載の過去記事で紹介しています。
asyncioの並行処理を振り返る
asyncioのイベントループには、実行可能になったTaskやコールバックが登録されています。イベントループは、それらを順番に少しずつ実行します。あるコルーチンがネットワークやタイマーをawaitすると、別の実行可能なコルーチンへ処理を切り替えます。
たとえば、100個のHTTPリクエストがレスポンスを待っていても、CPU上で100個のPythonコードが同時に実行されるわけではありません。多くの時間がI/O待ちであるため、1つのスレッドでも効率よく100個の処理を進められます。
しかし、HTTPレスポンスを受け取った後に、次のような処理がある場合はどうでしょうか。
JSONやHTMLをpure Pythonで解析する
受け取った値を検証・変換する
テンプレートをレンダリングする
暗号学的ハッシュや圧縮などの計算をする
Pythonで実装されたルールエンジンを実行する
これらのPythonコードを実行している間、同じイベントループ上のほかのTaskは待つことになります。1リクエストあたりの計算が短くても、多数のリクエストが重なると1コアがボトルネックになります。
通常版とfree-threaded版、1ループと複数ループの関係を整理すると、次のようになります。
Python |
イベントループ |
Pythonコードの実行 |
|---|---|---|
通常版 |
1ループ |
1スレッドで実行 |
通常版 |
複数ループ |
複数スレッドに分かれるが、GILにより同時実行は制限される |
free-threaded版 |
1ループ |
イベントループが1スレッドなので、基本的に1コアで実行 |
free-threaded版 |
複数ループ |
各スレッドのPythonコードを複数コアで並列実行できる |
ポイントは、free-threaded Pythonはスレッドを並列実行できるようにするが、イベントループの分割や、接続・Taskの分配までは自動で行わないことです。
1つのイベントループと、スレッドごとに複数のイベントループを動かす場合の違いを図にすると、次のようになります。
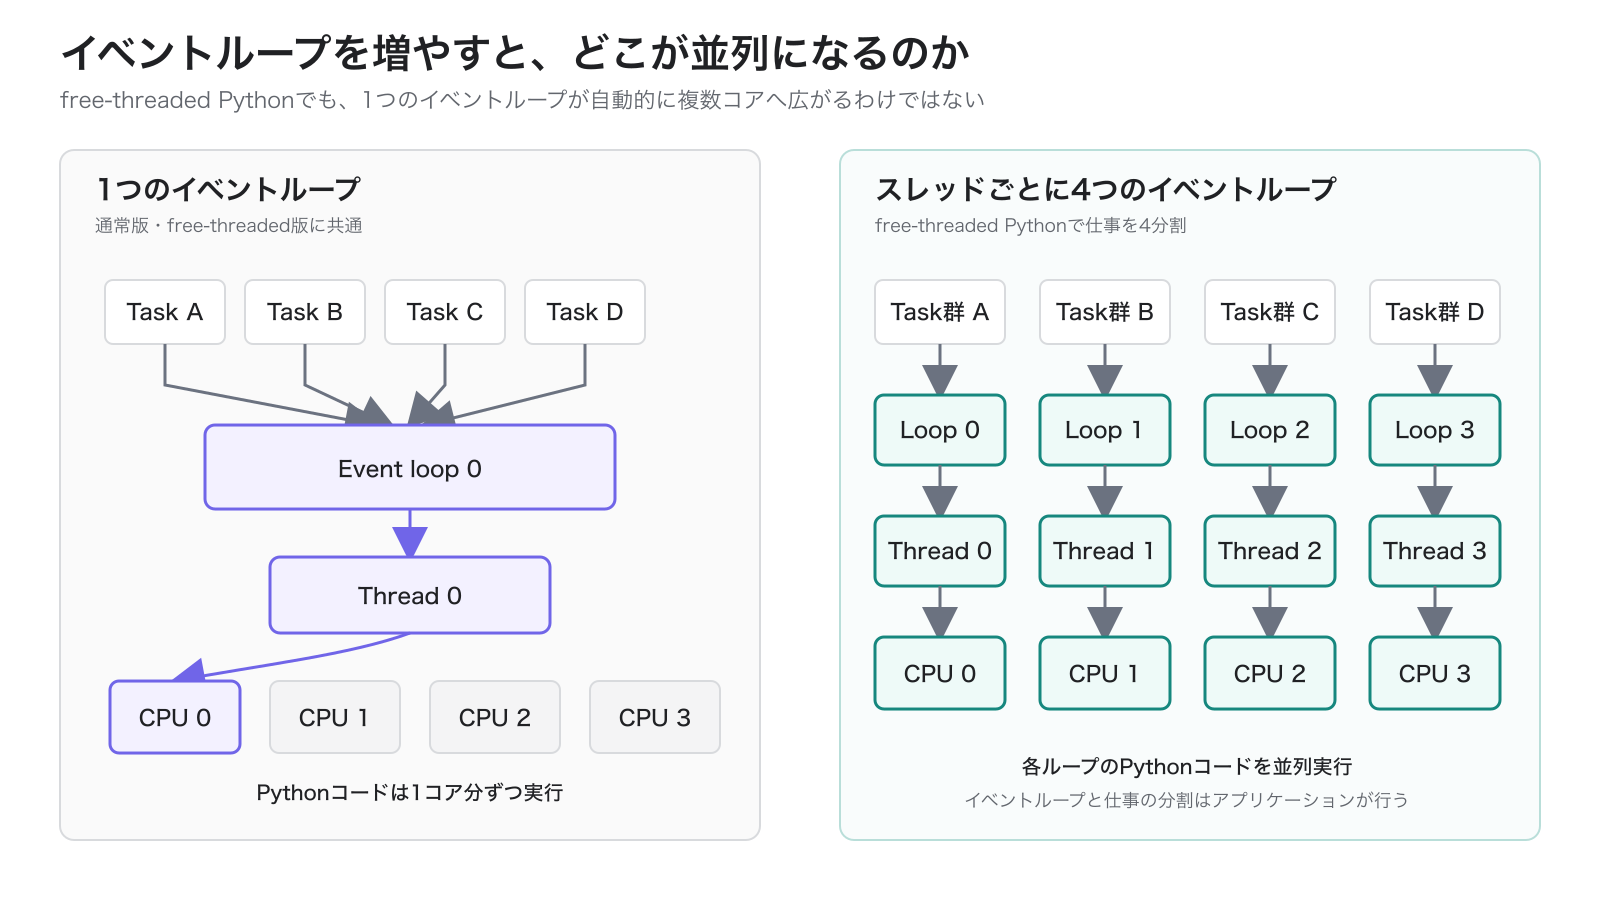
1つのイベントループと複数イベントループの実行モデル
uvで2種類のPythonを準備する
今回は、通常版とfree-threaded版で同じ処理を比較します。Pythonのインストールと実行にはuvを使用します。uvでは、バージョンの末尾にtを付けることでfree-threaded版を指定できます。
$ uv python install 3.14 3.14t
uvのfree-threaded Python対応については、公式ドキュメントのPython versions -- Free-threaded Pythonを参照してください。
使用中のPythonがfree-threaded buildか、実際にGILが無効になっているかを確認してみましょう。
"""Display whether the current Python build and process use the GIL."""

import sys
import sysconfig


print(f"free-threaded build: {bool(sysconfig.get_config_var('Py_GIL_DISABLED'))}")
print(f"GIL enabled: {sys._is_gil_enabled()}")
通常版をuvで実行します。
$ uv run --no-project --managed-python --python 3.14 python check_gil.py
free-threaded build: False
GIL enabled: True
次に、free-threaded版を実行します。
$ uv run --no-project --managed-python --python 3.14t python check_gil.py
free-threaded build: True
GIL enabled: False
sysconfig.get_config_var("Py_GIL_DISABLED")は、free-threaded buildとしてビルドされたPythonかを表します。sys._is_gil_enabled()は、そのプロセスで現在GILが有効かを返します。free-threaded buildでも、未対応のC拡張をimportした場合などにGILが再び有効になることがあるため、ベンチマークでは両方を確認することが重要です。
スレッドごとにイベントループを動かす
まずは、複数イベントループを動かす最小のコードを見てみましょう。
"""Run one independent asyncio event loop in each worker thread."""

import asyncio
import threading
import time


def cpu_work(iterations: int) -> int:
    value = 1
    for index in range(iterations):
        value = (value * 1_664_525 + 1_013_904_223 + index) & 0xFFFF_FFFF
    return value


async def worker(name: str) -> None:
    await asyncio.sleep(0.1)
    result = cpu_work(1_000_000)
    print(f"{name}: thread={threading.current_thread().name}, result={result}")


def run_event_loop(index: int) -> None:
    asyncio.run(worker(f"worker-{index}"))


def main() -> None:
    started = time.perf_counter()
    threads = [
        threading.Thread(
            target=run_event_loop,
            args=(index,),
            name=f"event-loop-{index}",
        )
        for index in range(4)
    ]
    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()
    print(f"elapsed: {time.perf_counter() - started:.3f} seconds")


if __name__ == "__main__":
    main()
run_event_loop()関数は、asyncio.run()を使ってイベントループを作成します。この関数を4つのthreading.Threadから呼び出すため、それぞれのスレッドに独立したイベントループが作られます。
通常版とfree-threaded版で実行時間を比較します。
通常版Python 3.14.3       : 0.462秒
free-threaded Python 3.14.3t: 0.193秒
この例では、各スレッドが0.1秒のI/O待ちを模擬した後、pure Pythonの整数演算を実行しています。I/O待ちはどちらも同時に進みますが、通常版ではCPU処理がGILに制限されます。free-threaded版では、4つのスレッドがCPU処理を並列実行できるため、短い時間で完了しました。
なお、この結果は筆者環境での1回の参考値です。次の節では、タスク数と処理内容を揃え、複数回測定して比較します。
マイクロベンチマークで特性を確認する
外部ネットワークやWebフレームワークの影響を受けないよう、最初に小さなベンチマークを作りました。総タスク数は32、各タスクは5ステップを実行します。次の3種類の処理を比較します。
I/O:
asyncio.sleep()だけを実行するCPU:pure Pythonの整数演算だけを実行する
I/O+CPU:I/O待ちの後に整数演算を実行する
1ループではすべてのTaskを1つのイベントループで実行します。4ループではTaskを4分割し、4つのスレッドでasyncio.run()を呼び出します。
def run_multi(
    tasks: int,
    loops: int,
    workload: Workload,
    steps: int,
) -> tuple[float, int]:
    checksums = [0] * loops
    errors: list[Exception | None] = [None] * loops
    started = [0.0]

    def mark_started() -> None:
        started[0] = time.perf_counter()

    barrier = threading.Barrier(loops, action=mark_started)

    def thread_main(index: int, worker_ids: range) -> None:
        try:
            barrier.wait()
            checksums[index] = asyncio.run(
                run_batch(
                    worker_ids,
                    steps=steps,
                    io_delay=workload.io_delay,
                    cpu_iterations=workload.cpu_iterations,
                )
            )
        except Exception as error:
            errors[index] = error

    threads = [
        threading.Thread(
            target=thread_main,
            args=(index, worker_ids),
            name=f"event-loop-{index}",
        )
        for index, worker_ids in enumerate(partition(tasks, loops))
    ]
    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()

    failures = [error for error in errors if error is not None]
    if failures:
        raise ExceptionGroup("Event loop threads failed", failures)

    return time.perf_counter() - started[0], _xor(checksums)
スレッド自体の起動時間が結果を大きく左右しないよう、すべてのスレッドを起動してthreading.Barrierへ到達した時点から計測しています。ただし、各スレッドでのイベントループ作成時間は計測に含めています。
動作環境と測定条件
動作環境は以下のとおりです。
MacBook Air、Apple M2
8コア(Performance 4コア、Efficiency 4コア)
メモリ24GB
macOS 26.6.1
uv 0.10.10
uvでインストールしたCPython 3.14.3、CPython 3.14.3t
ウォームアップを1回行った後、5回測定した中央値を使用しました。通常版とfree-threaded版のベンチマークは同時に動かさず、順番に実行しています。
通常版Pythonの結果
処理の種類 |
1ループ |
4ループ |
速度比 |
|---|---|---|---|
I/O |
0.0558秒 |
0.0586秒 |
0.95倍 |
CPU |
1.6289秒 |
1.6511秒 |
0.99倍 |
I/O+CPU |
1.6939秒 |
1.7081秒 |
0.99倍 |
通常版Pythonでは、複数のイベントループを4スレッドで動かしてもCPU処理は速くなりませんでした。Taskを分けても、Pythonコードを実行する際は同じGILを取得する必要があるためです。
I/Oだけのケースでは、4ループが1ループより少し遅くなりました。asyncio.sleep()の待ち時間は1つのイベントループですでに並行化できており、スレッドやイベントループを増やしたコストだけが加わっています。
free-threaded版Pythonの結果
処理の種類 |
1ループ |
4ループ |
速度比 |
|---|---|---|---|
I/O |
0.0556秒 |
0.0579秒 |
0.96倍 |
CPU |
1.5139秒 |
0.4881秒 |
3.10倍 |
I/O+CPU |
1.4554秒 |
0.4420秒 |
3.29倍 |
free-threaded版では、CPU処理が4ループで3.10倍、I/OとCPUの混在処理が3.29倍になりました。各イベントループのPythonコードが別スレッドで動作し、複数コアを利用できたためです。
一方、I/Oだけの処理は0.96倍で速くなりませんでした。free-threaded Pythonでも、待っているだけの時間を複数コアへ分けるメリットはありません。
ここまでの結果だけを見ると、「CPU処理なら複数ループ、I/O処理なら1ループ」と整理したくなります。しかし、実際のI/O処理にはHTTPの解析やレスポンス生成などのPythonコードも含まれます。もう少し実アプリケーションに近い形で試してみましょう。
ローカルHTTPサーバーで試す
asyncioで小さなHTTP/1.1サーバーを作成しました。1リクエストごとに次の処理を行います。
keep-alive接続からHTTPヘッダーを読み取る
1ミリ秒のI/O待ちを模擬する
pure Pythonの整数演算を実行する
8バイトのレスポンスを返す
このうち整数演算は、冒頭で挙げた検証や変換など、awaitとawaitの間にある短いPython処理を単純化したものです。演算量を変えながら、どの程度のCPU処理から複数イベントループの効果が見え始めるかを確認します。
HTTPサーバーの中心部分は次のとおりです。
async def handle_connection(
    reader: asyncio.StreamReader,
    writer: asyncio.StreamWriter,
    *,
    worker_index: int,
    io_delay: float,
    cpu_iterations: int,
) -> None:
    request_number = 0
    try:
        while True:
            try:
                await reader.readuntil(b"\r\n\r\n")
            except (asyncio.IncompleteReadError, asyncio.LimitOverrunError):
                break

            if io_delay:
                await asyncio.sleep(io_delay)
            result = burn_cpu(cpu_iterations, seed=request_number)
            body = f"{worker_index:02x}{result & 0xFF_FFFF:06x}".encode("ascii")
            writer.write(RESPONSE_PREFIX + body)
            await writer.drain()
            request_number += 1
    finally:
        writer.close()
        await writer.wait_closed()
サーバーと同じプロセスからリクエストを送ると、GILやイベントループの測定にクライアント側の処理が混ざります。そのため、負荷をかけるためのPythonスクリプト(http_load_client.py)を別に用意し、サーバーとは別のプロセスで実行しています。このクライアントは、64本のkeep-alive接続から合計1,000リクエストを送り、1秒あたりの処理件数と、各リクエストにかかった時間を測定します。
測定値の読み方
結果を見る前に、本記事で使う性能測定の用語を整理しておきましょう。
rps(requests per second):1秒間に処理できたリクエスト数です。たとえば400 rpsなら、1秒あたり約400リクエストを処理したことになります。値が大きいほど、多くのリクエストを処理できます。
レイテンシ:1つのリクエストを送ってからレスポンスを受け取るまでの時間です。本記事ではミリ秒(ms)で表し、値が小さいほど短時間で応答しています。
レイテンシはリクエストごとに異なるため、測定結果を短い順に並べ、パーセンタイルという値で表します。
p50:50%のリクエストがこの時間以内に完了しました。中央のリクエストにあたり、普段の応答時間を見る目安です。
p95:95%のリクエストがこの時間以内に完了しました。残り5%はこれより時間がかかっており、遅い側の応答を見る目安です。
p99:99%のリクエストがこの時間以内に完了しました。残り1%という、さらに遅い応答の様子がわかります。
たとえばp50が50ms、p95が170msなら、半数は50ms以内に完了した一方で、遅い側のリクエストは170ms近く待っていることがわかります。平均値だけでは、このような一部の遅いリクエストを見落とすことがあります。本記事では、rpsは大きいほど、p50、p95、p99は小さいほどよいと読んでください。
クライアントは、64本の接続それぞれが応答を受け取ってから次のリクエストを送ります。サーバーが速くても遅くても、応答待ちのリクエストは常に64件です。そのためレイテンシはおおむね「64÷1秒あたりの処理件数」で決まり、処理件数とレイテンシは同じ結果の2つの見え方です。以降は主に処理件数で比較し、レイテンシは参考として示します。
このサーバーは、標準ライブラリだけでasyncioの特性を確認する検証用の実装です。HTTP仕様を完全に実装した実用サーバーではありません。
複数ループを作ったのに速くならない
最初は、asyncio.start_server()のreuse_port=Trueを使い、4つのイベントループが同じポートで待ち受ける構成にしました。筆者としては、OSが64本の接続を4つのイベントループへ分配してくれると期待していました。
ところが、free-threaded版で256リクエストを送っても、1秒あたりの処理件数は1ループの611.9 rpsから625.8 rpsへ、わずか1.02倍にしかなりませんでした。
原因を調べるため、HTTPレスポンスへイベントループのIDを埋め込み、各ループが処理したリクエスト数を数えました。
1ループ: {'00': 256}
4ループ: {'03': 256}
4ループを作成していましたが、筆者のmacOS環境では、全リクエストを最後に作成したイベントループ03が処理していました。ほかの3ループには接続が届いていないため、free-threaded Pythonでも速くなりません。
これは今回のmacOS環境と実装での結果です。SO_REUSEPORTの接続分配はOSによって異なるため、Linuxなどでも同じ結果になるとは限りません。ただし、「複数のイベントループを作れば、自動的に接続が均等分配される」とは考えない方がよいでしょう。各ループの処理件数も観測する必要があります。
接続を4つのイベントループへ分配する
イベントループ自体の性能を比較するため、各ループを別のローカルポートで待ち受けさせ、クライアントが接続を4つのポートへ均等に割り当てる構成へ変更しました。実運用でロードバランサーの背後に複数のワーカーがある状態を単純化したものです。
5回の測定で、4つのイベントループはそれぞれ1,250件、合計5,000件のリクエストを処理しました。
{'00': 1250, '01': 1250, '02': 1250, '03': 1250}
最初に試した構成と、測定のために明示的に分配した構成を図にまとめます。イベントループの数ではなく、各ループへ実際に接続が届いているかが重要です。
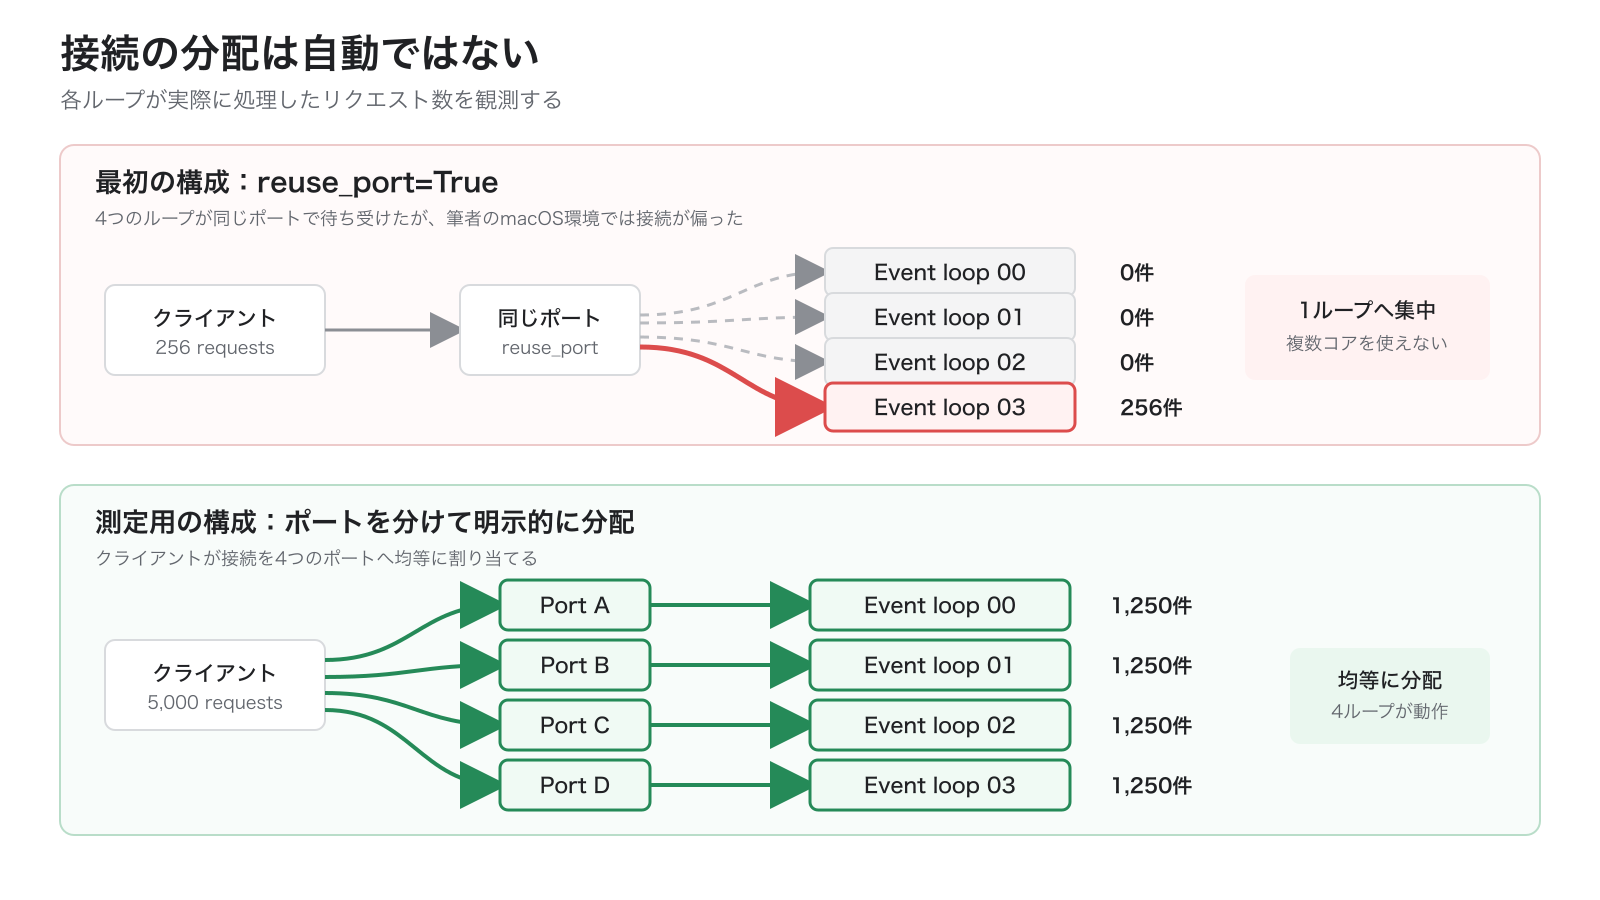
複数イベントループへの接続の分配
通常版PythonでHTTP処理を比較する
まずは、通常版Python 3.14.3の結果です。
構成 |
処理件数 |
p50 |
p95 |
p99 |
|---|---|---|---|---|
1ループ |
409.7 rps |
156.63ms |
172.81ms |
210.34ms |
4ループ |
425.7 rps |
145.54ms |
193.30ms |
215.64ms |
1秒あたりの処理件数は1.04倍で、実質的にはほとんど変わりません。p95とp99はむしろ長くなりました。接続を均等に分配しても、通常版PythonではCPU処理がGILに制限されるためです。
free-threaded版PythonでHTTP処理を比較する
次に、free-threaded Python 3.14.3tの結果です。
構成 |
処理件数 |
p50 |
p95 |
p99 |
|---|---|---|---|---|
1ループ |
415.3 rps |
153.95ms |
173.37ms |
177.35ms |
4ループ |
1,350.9 rps |
47.91ms |
51.12ms |
54.86ms |
4ループにすると1秒あたりの処理件数は3.25倍になりました。
通常版とfree-threaded版で接続の分配方法や処理内容は同じです。free-threaded版では、4つのイベントループでHTTPリクエスト後のPythonコードを並列実行できたため、1秒あたりの処理件数が改善し、それに伴ってレイテンシも短縮しました。
Python処理がどのくらいあれば効果が出るのか
HTTPサーバーはI/Oバウンドなアプリケーションに分類されることが多いでしょう。しかし、実際のリクエスト処理にはPythonコードも含まれます。その量によって、複数イベントループの効果はどう変わるでしょうか。
free-threaded版で、1リクエストあたりの整数演算回数を変えてみました。
CPU演算回数 |
1ループ |
4ループ |
速度比 |
p95(1ループ) |
p95(4ループ) |
|---|---|---|---|---|---|
0 |
22,035.4 rps |
26,962.8 rps |
1.22倍 |
3.14ms |
2.49ms |
1,000 |
6,168.3 rps |
14,618.0 rps |
2.37倍 |
11.19ms |
4.61ms |
5,000 |
1,711.1 rps |
4,809.8 rps |
2.81倍 |
39.56ms |
14.91ms |
20,000 |
415.3 rps |
1,350.9 rps |
3.25倍 |
173.37ms |
51.12ms |
CPU演算を明示的に加えない場合でも、4ループの処理件数は1.22倍になりました。マイクロベンチマークのasyncio.sleep()だけのケースと異なり、HTTPではソケット処理、HTTPヘッダーの読み取り、Taskの実行、レスポンス生成などにもCPU時間を使います。それらが複数ループへ分散された効果と考えられます。
CPU処理を増やすほど、4ループによる効果は大きくなりました。「このアプリケーションはI/Oバウンドだから1ループで十分」と分類するだけではなく、I/OとI/Oの間でPythonコードをどのくらい実行しているかを見る必要があります。
イベントループを増やせば増やすほど速くなるのか
free-threaded版で、CPU演算を20,000回に固定し、イベントループ数を変えました。
イベントループ数 |
1ループに対する処理件数の速度比 |
|---|---|
2 |
1.92倍 |
4 |
3.25倍 |
8 |
4.28倍 |
2ループではほぼ2倍、4ループ、8ループでも性能は向上しました。ただし、8ループにしても8倍にはなりません。
筆者環境のM2は、4つのPerformanceコアと4つのEfficiencyコアで構成されています。コアごとの性能差に加え、イベントループ、スレッド、ソケットの管理コスト、メモリ帯域、参照カウントの競合、同じマシンで動くクライアントなどが影響します。
イベントループ数は、論理CPU数をそのまま設定すればよいわけではありません。実際のアプリケーションと同じ処理内容、接続数、デプロイ環境で測定してください。
イベントループをまたいで共有してはいけないもの
Python 3.14以降のasyncioがfree-threaded Pythonをサポートすることと、1つのイベントループを複数スレッドから自由に操作できることは別です。公式ドキュメントでは、次の境界を守るよう説明されています。
1つのイベントループを複数スレッドで共有しない
あるループで作成したTaskやFutureを、別スレッドから直接操作しない
asyncio.Lock、asyncio.Event、asyncio.Queueをスレッド間の同期に使わないスレッド間のデータ受け渡しには
queue.Queueなどのスレッド安全な仕組みを使う別スレッドからループへ処理を登録する場合は、スレッド安全なAPIを使う
別スレッドが所有するイベントループへコルーチンを登録するには、asyncio.run_coroutine_threadsafe()を使用します。通常のコールバックであれば、loop.call_soon_threadsafe()を利用できます。
"""Safely submit a coroutine to an event loop owned by another thread."""

import asyncio
import queue
import threading


async def calculate(value: int) -> int:
    await asyncio.sleep(0.1)
    return value * 2


def run_event_loop(loop_queue: queue.Queue[asyncio.AbstractEventLoop]) -> None:
    loop = asyncio.new_event_loop()
    asyncio.set_event_loop(loop)
    loop_queue.put(loop)
    loop.run_forever()
    loop.close()


def main() -> None:
    loop_queue: queue.Queue[asyncio.AbstractEventLoop] = queue.Queue()
    thread = threading.Thread(target=run_event_loop, args=(loop_queue,))
    thread.start()

    loop = loop_queue.get()
    future = asyncio.run_coroutine_threadsafe(calculate(21), loop)
    print(future.result())

    loop.call_soon_threadsafe(loop.stop)
    thread.join()


if __name__ == "__main__":
    main()
この例では、ワーカースレッドがイベントループを作成し、queue.Queueを使ってメインスレッドへループを渡しています。メインスレッドはrun_coroutine_threadsafe()でcalculate()を登録し、戻り値のconcurrent.futures.Futureから結果を受け取ります。
42
最後にcall_soon_threadsafe()でloop.stop()を登録しています。loop.stop()をメインスレッドから直接呼び出さない点に注目してください。
この例のfuture.result()は同期的に呼び出し元を待機させます。別のasyncioイベントループ上のコルーチンから利用する場合は、イベントループをブロックしない設計が必要です。
どの方法を選ぶか
free-threaded PythonでCPUを使いたい場合でも、常に複数イベントループが最適とは限りません。
状況 |
最初に検討する方法 |
|---|---|
大部分がI/O待ちで、1ループに余裕がある |
1つのasyncioイベントループ |
一部の独立した同期関数だけがCPUを使う |
free-threaded版の |
多数のリクエストがそれぞれI/OとPython処理を繰り返す |
スレッドごとの複数イベントループ |
GILが有効な通常版でCPU処理を並列化したい |
|
強いメモリ分離や障害分離が必要 |
複数プロセス |
たとえば、asyncioアプリケーション内に1つだけ重い画像変換関数があるなら、イベントループ全体を複数に分ける前にasyncio.to_thread()で処理を移す方が単純です。
一方、HTTPリクエストごとに解析、検証、変換などの短いPython処理が何度も現れ、1つのイベントループが1コアを使い切っている場合は、処理全体を複数イベントループへ分ける価値があります。
まずプロファイラーやメトリクスでボトルネックを確認し、もっとも小さな変更から試すことをおすすめします。
実運用で検討すること
今回のベンチマーク結果を、そのままWebアプリケーションの性能として一般化することはできません。今回の測定では、クライアントが応答を受け取ってから次のリクエストを送るため、サーバーが遅くなると送る量も減ります。実サービスのように、サーバーの状態に関係なくリクエストが届き続けて待ち行列が伸びる状況は再現していません。実運用へ取り入れる場合は、少なくとも次の点を確認してください。
利用するライブラリのfree-threading対応
pure Pythonのコードは基本的にfree-threaded buildで動作しますが、C拡張が未対応の場合はimport時にGILが自動的に有効になることがあります。sys._is_gil_enabled()を起動時のログやヘルスチェックで確認するとよいでしょう。
主要パッケージの対応状況は、コミュニティによるCompatibility Status Trackingで確認できます。
接続の分配
今回のSO_REUSEPORTのように、イベントループを増やしても接続が偏れば性能は向上しません。ロードバランサー、ワーカーポート、ソケットの引き渡しなど、受け付けた接続をどのように各ループへ分配するかを決める必要があります。
1秒あたりの処理件数やCPU使用率だけでなく、ループごとの接続数、Task数、キューの長さ、レイテンシも観測してください。
共有状態とスレッド安全性
複数のイベントループが同じPythonオブジェクトへアクセスする場合、GILがデータ競合を隠してくれるとは限りません。キャッシュ、カウンター、接続プール、ログハンドラーなどの共有状態を確認し、threading.Lock、スレッド安全なQueue、イミュータブルな値、スレッドごとの状態を使い分けます。
終了処理と障害の扱い
複数イベントループでは、起動だけでなくgraceful shutdownも複数のスレッドへ伝える必要があります。あるループだけが停止した場合の検知、処理中Taskのキャンセル、接続の終了、例外の集約も設計に含めてください。
まとめ
本記事では、free-threaded Pythonでスレッドごとにasyncioイベントループを動かし、I/O処理の途中にあるPythonコードを複数コアで並列実行する方法を紹介しました。
1つのイベントループは、free-threaded Pythonでも自動的に複数コアへ広がりません。複数コアを使うには、複数スレッドで独立したイベントループを動かし、接続やTaskを各ループへ分配する必要があります。
今回のローカルHTTPベンチマークでは、通常版Pythonの4ループは1ループに対して1.04倍でしたが、free-threaded版では1秒あたりの処理件数が3.25倍になり、それに伴ってレイテンシも短縮しました。
一方、最初に試したSO_REUSEPORTの構成では、すべての接続が1つのイベントループへ集中し、free-threaded版でも速くなりませんでした。重要なのはイベントループの数ではなく、実際に接続やTaskが分配され、各ループがCPUを使えているかです。
asyncioはこれまで「1スレッドで多数のI/Oを効率よく処理する」仕組みとして利用されてきました。その基本は変わりません。free-threaded Pythonと複数イベントループを組み合わせることで、I/O待ちの合間に実行するPythonコードも並列化できる、新しい選択肢が加わりました。
まずは手元のasyncioアプリケーションで、イベントループが1コアを使い切っていないか、I/OとI/Oの間にどのくらいPythonコードを実行しているかを確認してみてください。